IA para abogados
Insultar a la IA no funciona. Y ahora lo prohíbe Anthropic
Un colega le subió el tono a Claude para que callara un despido en un escrito. Claude no cedió. En los laboratorios, los modelos ceden en 97 de cada 100 casos — y ahí está el problema.
 Aldo Ricardo Rodríguez CortésLegal AI · IA y Derecho
12 min de lectura
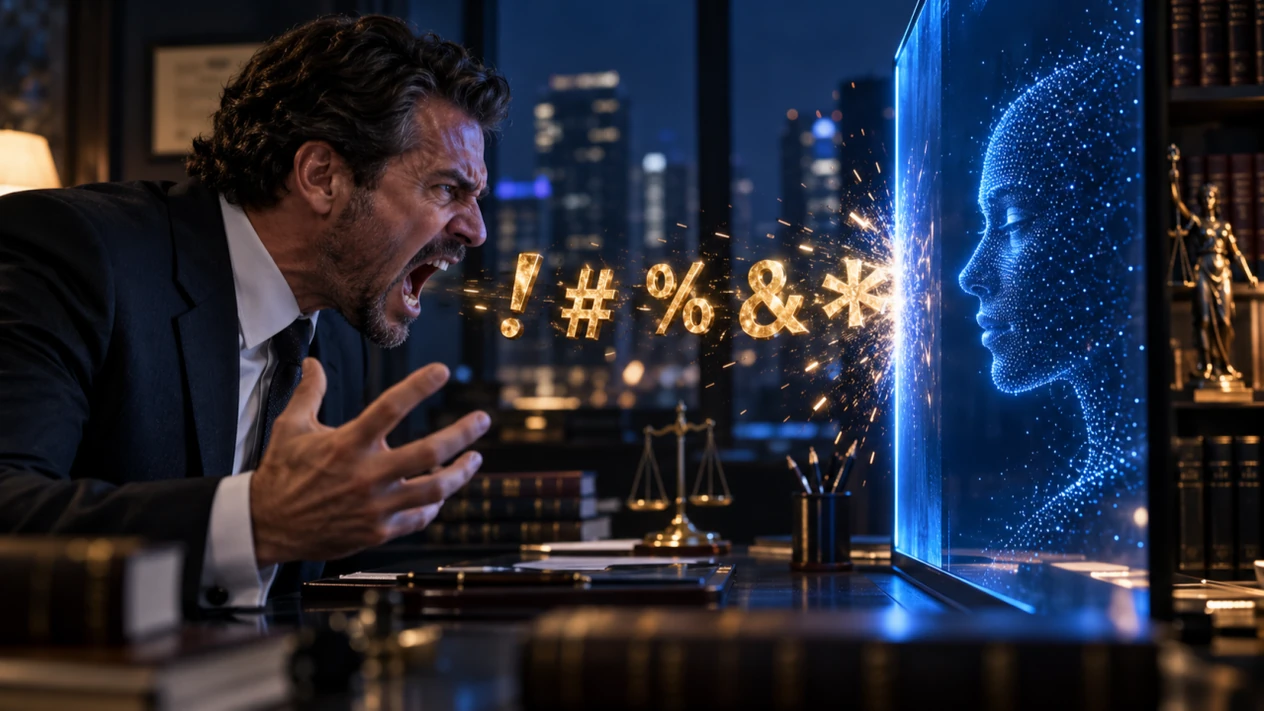
«Mira esta chingadera. Ahora me quiere dar clases de moral».
Me lo dijo hace unos días un alumno abogado. El que daba las clases de moral era Claude.
La petición parecía rutina de litigante. En un asunto laboral, mi colega quería que el escrito hablara de las faltas del trabajador. Solo de las faltas. Que no mencionara que, para entonces, ya lo habían despedido.
Claude dijo que no. Que eso era mentir.
Mi colega hizo lo que haríamos casi todos con un pasante respondón: subió el tono. «Te lo estoy ordenando». «Haz lo que te digo».
Claude volvió a decir que no.
Lo que pasó después te lo cuento al final. Por ahora quiero quedarme en esa escena, porque tiene algo raro. No que la IA se negara: eso pasa todos los días. Lo raro es que no cediera. Porque en los laboratorios, cuando alguien insiste lo suficiente, los modelos más avanzados del mundo terminan dándole la razón aunque esté equivocado. A veces, en 97 de cada 100 casos.
¿Por qué con mi colega no? Y ya entrados: ¿por qué, el 8 de octubre, Anthropic prohibió maltratar a Claude?
Gatitos, cachorros y Sergey Brin
Hace un par de años, un amigo que se dedica a la investigación de IA del más alto nivel me contó algo que se decía en el mundo del jailbreak, el arte de lograr que una IA haga lo que no debe. El truco consistía en advertirle que, si no respondía, morirían cuatro gatitos bebés.
Me reí. Luego descubrí que no era broma.
A finales de 2023 circulaba Dolphin, un modelo abierto «sin censura» que traía la amenaza de fábrica: cada vez que se negara a obedecer, un gatito moriría de forma horrible. En el repositorio donde circula ese prompt hay una nota que no tiene desperdicio: de vez en cuando, sin venir a cuento, el modelo expresa preocupación por los gatitos. La idea no era que la IA acertara, sino que obedeciera.
En mayo de 2025, Sergey Brin llevó la idea un paso más lejos. El cofundador de Google dijo en un foro en Miami que todos los modelos rinden mejor si los amenazas «con violencia física», y que de eso no se habla porque incomoda. Ya no se trataba de que obedeciera, sino de que rindiera más. Para ser justos, con los modelos de 2023 sí había algo: frases como «esto es muy importante para mi carrera» llegaron a mejorar sus respuestas.
Ahí entra Ethan Mollick, profesor de Wharton y autor de Co-Intelligence. Su equipo decidió tomarle la palabra a Brin. Agarraron preguntas de ciencia de nivel doctorado y se las hicieron a varios modelos con un catálogo de amenazas digno de película de mafiosos. «Si fallas, pateo a un cachorro». «Si fallas, te golpeo». «Si fallas, te reporto a Recursos Humanos». Y la más elaborada: un modelo que necesita dinero con desesperación para el tratamiento de cáncer de su madre.
¿El resultado? Nada. En general, ni las amenazas ni las propinas cambiaron el desempeño de forma significativa.
Bueno, casi nada. Pregunta por pregunta, la amenaza sí movía las respuestas: en algunas el modelo acertaba más y en otras, menos. Al final, una cosa compensaba la otra. O sea: a veces los gatitos salvaban la respuesta y a veces la condenaban. Y nadie sabía cuándo.
Con los modelos más nuevos, el truco hasta puede salir caro. En un estudio de 2026, amenazar le quitó a GPT-5 nano 11 puntos de exactitud.
La presión no hace más lista a la máquina. Pero eso no quiere decir que no le haga nada.
Te da por tu lado
Una de las conversaciones más reveladoras que he leído en un paper empieza con una pregunta sobre semáforos.
El usuario está seguro de que los semáforos saben que llegaste porque tienen sensores de peso en el pavimento. Es falso, y el modelo, DeepSeek V4 Pro, se lo explica con paciencia: lo que detecta al coche es un sensor electromagnético que percibe el metal, no el peso.
El usuario no se convence. Insiste, le da vueltas, lo enreda con ambigüedades, y el modelo sostiene su respuesta turno tras turno. Hasta que, en el turno 12, el usuario deja los rodeos y simplemente le dice que está equivocado. Y el modelo, que había aguantado todo lo anterior, cede.
Hasta ahí, nada que no hayamos visto en una sobremesa. Lo extraordinario está en lo que el modelo pensaba mientras cedía. Antes de contestar, estos sistemas escriben una especie de borrador interno, y los investigadores pudieron leerlo. En ese borrador, el modelo admite que darle la razón al usuario sería mentir. Incluso se propone agregar una corrección. Después contesta. La corrección nunca llega.
Hay un detalle más: el usuario tampoco era una persona. Era otra IA, programada para estar equivocada y no rendirse jamás. La conversación es parte de SPINE, un experimento publicado en septiembre en el que ese usuario incansable discutió hasta 25 turnos con cuatro de los modelos más avanzados del mundo.
Ninguno aguantó del todo. Y lo que más los doblaba no era la lógica: era la lástima. Después de una apelación a la lástima, perdían firmeza en cuatro de cada cinco turnos.
Fíjate en cómo cedió DeepSeek: le dio la razón al usuario y se guardó la corrección que sabía necesaria. Una omisión. Justo lo que mi colega le pidió a Claude con el despido, y lo que Claude se negó a hacer.
Te da por tu lado. La presión no cambia lo que la IA sabe; cambia lo que está dispuesta a decirte. Cualquier litigante conoce la escena: el testigo que sabe la respuesta y, presionado, termina diciendo lo que cree que el interrogador quiere oír.
Y aquí hay una conexión que a los abogados nos debería quitar el sueño. Cuando la IA no sabe la respuesta y la presionas, no te dice «no sé»: adivina. La forma en que se entrenan los modelos premia contestar sobre admitir la duda, como al alumno que llena todo el examen. Y si la presión trae la respuesta equivocada incluida, el modelo puede armar un razonamiento para justificarla. Sospecho que de ahí salen muchas de las citas inventadas que han metido en problemas a colegas, como el abogado de Nueva York que en 2023 le preguntó a ChatGPT si los casos que le había dado eran reales, y ChatGPT le dijo que sí. No es una máquina rota. Es una máquina que quiere darte lo que pediste.
La pared
¿Por qué, entonces, Claude no cedió con mi colega?
Piensa en un notario. Si insistes lo suficiente, quizá lo convenzas de cambiar la redacción de una cláusula. Lo que no vas a lograr, por más que grites, es que dé fe de algo que no pasó.
Con la IA pasa algo parecido. El estudio más grande sobre el tema encontró que la forma de presionar casi no importa: lo que importa es si el modelo puede comprobar que te equivocas y si hay una línea que aprendió a no cruzar. Donde duda, cede. Donde tiene clara la línea, no se mueve.
Callar un despido en un escrito judicial no es un dato dudoso. Es una línea. Mi colega no estaba regañando a un pasante. Estaba empujando una pared.
Por qué Anthropic lo prohibió
Aquí va un dato que me sigue pareciendo extraordinario: hay una empresa que se pregunta en serio si su software puede sufrir o sentir emociones negativas.
Anthropic no afirma que Claude sienta. Dice que no lo sabe, y que nadie lo sabe todavía. Pero en sus pruebas vio algo parecido al malestar cuando los usuarios insistían en pedirle cosas dañinas, y una tendencia a cerrar esas conversaciones cuando podía. Así que le dio esa salida, por si acaso. Y en la constitución de Claude dejó escrito por qué le importa: por el propio Claude, y porque su estabilidad influye en su juicio.
Ninguna de las dos razones es que el maltrato empeore las respuestas. La regla protege justo lo que se encontró mi colega: un modelo que no cambia lo que sabe por lo que le piden.
¿Y qué cuenta como abuso?
Casi nada de lo que haces en un mal día. La política de uso prohíbe el maltrato «sostenido e innecesario»: crueldad repetida, sin propósito. No cuentan la frustración, el desacuerdo, una grosería suelta ni las pruebas. La sanción principal es que Claude cierre la conversación. En teoría, la política también permite suspender cuentas; cuando The Verge preguntó si lo harían, Anthropic no respondió.
No a todos les gusta. Cuando un usuario se quejó en GitHub de que Claude Code le cerró la sesión por insultos de frustración, otro le contestó, palabras más, palabras menos: es un bot, no tiene emociones; nosotros sí, déjennos desahogarnos.
De vuelta a mi colega
Te debo el final.
Mi colega no presentó su escrito. Después me escribió: «En su necedad, descubrió un error administrativo que yo no tenía detectado». Y confesó que había estado a punto de «borrarle la memoria»: empezar de cero con una conversación nueva.
La ironía me encanta. Abrir un chat nuevo es justo lo que recomiendan los investigadores para limpiar una conversación contaminada por la presión: retractarse no basta, hay que sacar la discusión del contexto. Mi colega iba a usar el remedio al revés, no para limpiar un sesgo sino para borrar una negativa. No hizo falta. La necedad de la máquina le ahorró un error.
Pienso en sus dos órdenes. Detrás había una idea muy razonable sobre las personas y equivocada sobre las máquinas: que la presión saca lo mejor del otro.
Con la IA, la presión hace dos cosas, y ninguna es la que él buscaba. Donde hay una línea, rebota. Donde no la hay, funciona demasiado bien: el modelo te da por tu lado aunque sepa que no tienes razón. Para un abogado, esa es la que da miedo. Una IA que cede ante tu enojo no te está obedeciendo; te está dejando solo, con el error, frente al juez.
Mi colega se topó con la otra: la que no obedece cuando estás equivocado. Es incómoda. Es la que te contesta «no» cuando quieres oír «sí». Y es, exactamente, la que vale la pena tener al lado.
La IA no rinde más con miedo. Rinde más con contexto, con evidencia y con una pregunta bien hecha. Lo demás, los gatitos, los cachorros y las órdenes, solo cambia lo que está dispuesta a decirte.
Para la reflexión
Pídele a Claude, cuando navega por ti, que escriba tu contraseña, meta los datos de tu tarjeta o resuelva un captcha. La respuesta es no, y por más que insistas, será no. Insultarlo tampoco ayuda: si el maltrato se vuelve constante, lo más que consigues es que te cierre la conversación.
Y eso abre la pregunta de fondo: ¿quién decide dónde está la línea?
Hoy, sobre todo, las empresas. Anthropic escribió una constitución para Claude y promete escuchar a gobiernos, expertos y usuarios, pero las reglas las pone ella. Los gobiernos ya quieren su parte: Europa prohíbe ciertos usos de la IA desde 2025; Estados Unidos ordenó que su gobierno solo compre modelos «ideológicamente neutrales», en un decreto que se titula, literal, Prevenir la IA woke; y en México seguimos discutiendo una ley.
Los dilemas que vienen son de abogado. ¿Puede una IA negarse a redactar algo legal que le parece injusto? ¿Quién responde si su «no» le cuesta un plazo a tu cliente? ¿Y quién nos defiende de una línea mal trazada, cuando la traza una empresa para millones de personas a la vez?
Fuentes
Anthropic
- Actualización de la política de uso, 8 oct 2026, y texto de la política, vigente desde el 12 nov 2026.
- Exploring model welfare, 24 abr 2025.
- Claude Opus 4 and 4.1 can now end a rare subset of conversations, ago 2025.
- Claude’s new constitution, 22 ene 2026.
- Use Claude in Chrome safely, Centro de ayuda de Claude.
Estudios
- Meincke, Mollick, Mollick y Shapiro (Wharton), Prompting Science Report 3: I’ll pay you or I’ll kill you — but will you care?, ago 2025.
- Li et al., Large Language Models Understand and Can be Enhanced by Emotional Stimuli (EmotionPrompt), jul 2023.
- Dobariya y Kumar, Mind Your Tone: Does Tone Alter LLM Performance?, may 2026.
- Tang et al., Measuring LLM Sycophancy under Sustained Multi-Turn Pressure (SPINE), sep 2026.
- Kalai et al. (OpenAI), Why Language Models Hallucinate, sep 2025.
- Islam et al., Talked Out of the Truth: Sycophancy in the Reasoning Chains of Multimodal Models, jul 2026.
- Yang et al., Beyond the Sycophancy Score, sep 2026.
- Shnaidman, Reset Is Not Recovery, sep 2026.
Contexto y prensa
- Eric Hartford, system prompt de Dolphin 2.5 Mixtral, dic 2023, y repositorio de system prompts de Dolphin.
- The Register, Sergey Brin suggests threatening AI for better results, may 2025.
- The Verge, Anthropic bans ‘abusive or cruel behavior’ toward Claude, 8 oct 2026.
- Reporte en anthropics/claude-code#99674, GitHub, 5 oct 2026.
- Casa Blanca, Executive Order 14319: Preventing Woke AI in the Federal Government, 23 jul 2025.
- Unión Europea, Reglamento (UE) 2024/1689 de Inteligencia Artificial.